
概念与工作流
猫译员把“翻译漫画”拆成四个可以单独运行的步骤,每个步骤都有自己的输入、输出和模型能力要求。
漫画的自动化翻译流程
Section titled “漫画的自动化翻译流程”完整的自动流程通常是:
检测文本块 → 提取文字 → 提取图片摘要 → 翻译| 步骤 | 作用 | 主要输入 | 主要输出 |
|---|---|---|---|
| 检测文本块 | 找出气泡、框内文字等文本区域 | 漫画图片 | 文本块位置;部分模型同时输出原文 |
| 提取文字 | 读取文本块中的原文 | 漫画图片和文本块 | 文本块原文 |
| 提取图片摘要 | 描述画面,为翻译提供上下文 | 漫画图片 | 图像描述 |
| 翻译 | 根据原文和上下文生成译文 | 原文、上下文、术语表 | 文本块译文 |
检测文本块和提取文字不是同一件事。检测只负责“文字在哪里”。提取文字负责“文字是什么”。
不同模型的能力有些许差异,比如 PaddleOCR VL 1.6 和 GLM-OCR 可以在检测文本块位置的同时提取文字,而本地文本块检测器仅检测文本块位置。
将这些环节拆分的好处,是人工可以在任意环节中介入、部分重做,同时可以由不同的成员协作完成。
- 提取文字需要先有文本块。文本块可以来自文本块检测模型,也可以由用户手动标记。
- 翻译需要文本块中有原文。原文可以来自文字提取模型,也可以由用户手动输入。
- 提取图片摘要可以独立运行。
- 翻译可以使用图片摘要结果作为上下文,但这不是翻译的硬性要求。
通用 AI:
通用 AI 配置中的每个模型都可以声明它承担的能力:
- 提取文字:需要视觉能力。模型会读取文本块区域。
- 提取图片摘要:需要视觉能力。模型会读取整页图片。
- 翻译:需要文本生成能力。
检测文本块:
需要专门适配的检测器。当前支持本地文本块检测器、PaddleOCR VL 1.6 和 GLM-OCR。通用 AI 模型在此项工作中精准度较差,遂暂不支持此能力。
文本提取:
需要专门适配的检测器。当前支持本地文本提取器。
后续还会增加如 图片修复 之类的专用模型接入。
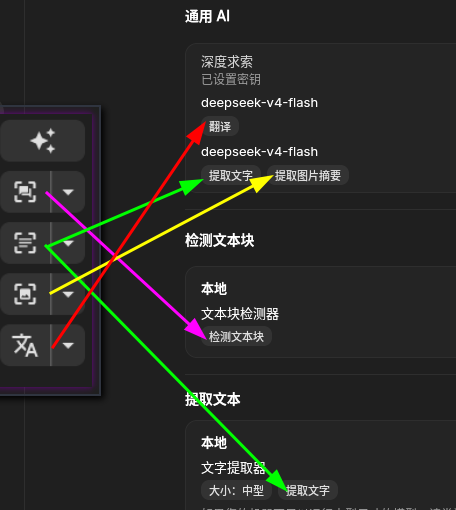
这些「服务配置」中的模型能力对应着漫画编辑界面上的几个自动化按钮:
结果是否会被覆盖
Section titled “结果是否会被覆盖”单独运行某一步时,通常可以选择只处理缺失结果,或重新处理全部对象。重新处理全部对象可能覆盖已有结果,包括人工修改过的原文或译文。批量处理前请先确认范围选项。
一次自动化操作,会对外发送什么
Section titled “一次自动化操作,会对外发送什么”发送给第三方服务的数据取决于步骤:
- 检测文本块通常发送整页图片。
- 本地文本块检测器离线工作,不向外发送数据。
- 提取文字会发送文本块对应的截图区域或整页图片,取决于服务实现。
- 提取图片摘要会发送整页图片。
- 翻译主要发送文本、上下文和术语表内容。
详情请阅读常见问题中的数据与隐私说明。