
Guía de inicio rápido
Neko Translator es un asistente con IA para traducir cómics y manga.
Tanto si eres un lector que traduce cómics en otros idiomas como si eres traductor profesional, puedes usarlo como plataforma para tu trabajo de traducción.
Esta guía te acompaña en la instalación, la configuración y la conexión con API de modelos en línea.
Sobre el consumo de tokens
Sección titulada «Sobre el consumo de tokens»Neko Translator en sí es gratuito, pero las API de modelos de terceros a las que se conecta pueden cobrarte. En nuestras pruebas, los trabajos de traducción habituales no cuestan mucho:
- Con gemma4-31b-it de OpenRouter como modelo de visión (con el razonamiento desactivado), reconocer unos 1000 cuadros de texto o imágenes cuesta alrededor de 0,089 US$.
- Con deepseek-v4-flash de la API oficial de DeepSeek (con el razonamiento activado), traducir 50 páginas de cómic cuesta alrededor de 0,074 US$.
- Si tienes una GPU potente, conectar un modelo local también es una buena forma de evitar estos costos.
Nota: Haz primero una pequeña traducción de prueba y vigila tu consumo de tokens para no generar cargos inesperados. Si tu proveedor lo permite, también te recomendamos establecer un límite de gasto en la clave de API.
Instalar Neko Translator
Sección titulada «Instalar Neko Translator»Visita nuestro sitio web en un navegador para descargar Neko Translator.
Configurar los servicios
Sección titulada «Configurar los servicios»Esta guía recomienda y usa google/gemma-4-31b-it como modelo de visión y deepseek/deepseek-v4-flash con el razonamiento activado como modelo de traducción.
google/gemma-4-31b-it es una opción económica que funciona bien para Extraer texto, pero sus resúmenes de imagen son solo regulares. Si dependes de Extraer resumen de imagen para dar contexto a la traducción, considera un modelo de visión más capaz; consulta Configuración de servicios: IA genérica.
Crear una cuenta y una clave de API de OpenRouter
Sección titulada «Crear una cuenta y una clave de API de OpenRouter»- Visita OpenRouter e inicia sesión o crea una cuenta.
- Si piensas usar modelos de pago, añade saldo en la página Credits.
- Abre la página Keys y selecciona Create Key.
- Ponle a la clave un nombre reconocible, créala, cópiala y guárdala en un lugar seguro. Solo tendrás que pegarla en Neko Translator una vez.
Configurar la IA genérica
Sección titulada «Configurar la IA genérica»Vuelve a Neko Translator y abre Perfiles de servicio.
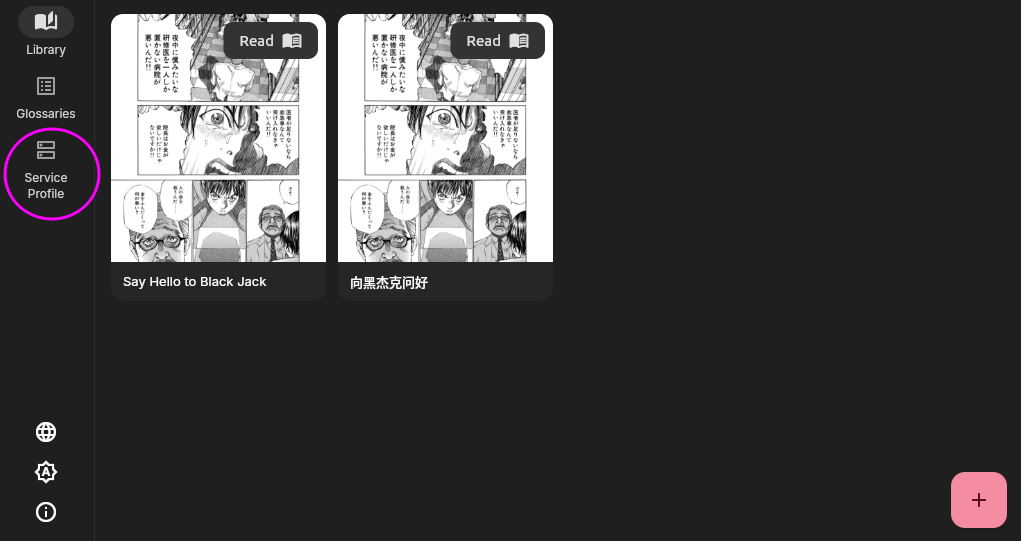
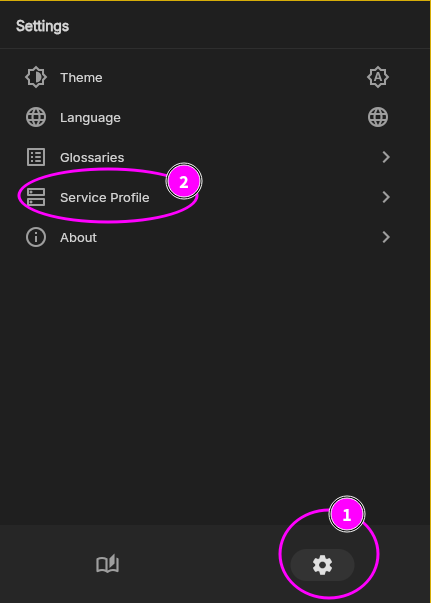
Primero, configura la API de OpenRouter:
- En API de IA general, selecciona + Añadir y elige OpenRouter.
- Pega la clave de API que empieza por
skque copiaste antes. - No cambies el preajuste de modelos que viene configurado.
- Guarda el perfil.
Configurar los modelos locales
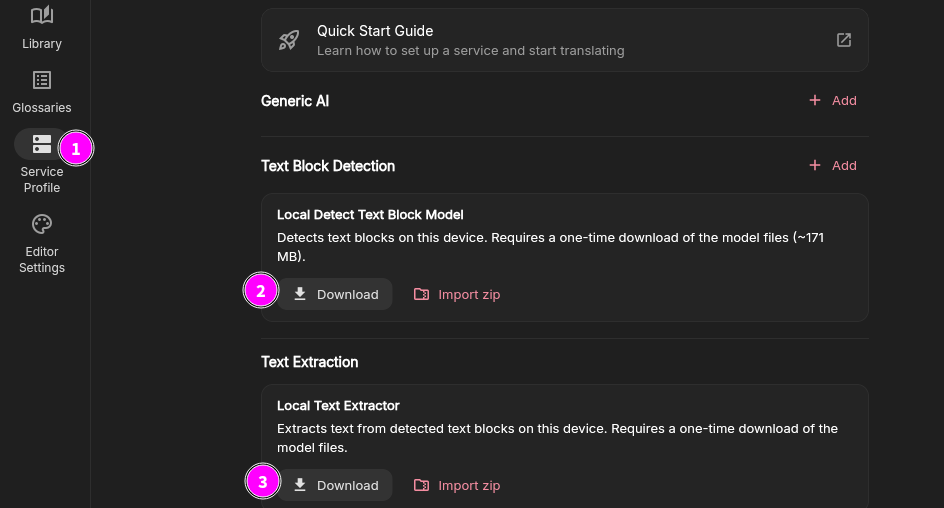
Sección titulada «Configurar los modelos locales»- Abre Perfiles de servicio.
- En Detección de bloques de texto, busca Modelo local de detección de bloques de texto y selecciona Descargar.
- En Extracción de texto, busca Extractor de texto local y selecciona Descargar. Empieza con el modelo Medium. Si funciona con lentitud, cambia a una versión más pequeña.
También puedes descargar estos modelos desde otras fuentes, como la página principal de Neko Translator. Selecciona Importar zip para importar un archivo comprimido del modelo.
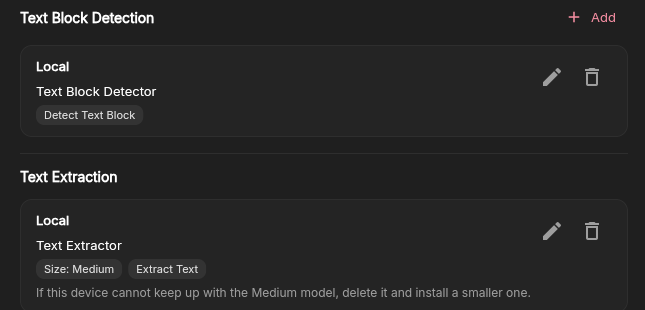
- Tras la configuración, el detector local de bloques de texto y el extractor de texto deberían aparecer como se muestra a continuación.
Probar la configuración
Sección titulada «Probar la configuración»Después de configurar todo, comprueba que cada etapa funciona como se espera:
- Añade un cómic y luego sube una o varias páginas.
- Haz clic en Detectar bloques de texto en la imagen. Si aparecen los cuadros de texto, el servicio de detección de bloques de texto está bien configurado.
-
Haz clic en Extraer texto de los bloques de texto. Si aparece texto en los bloques, el servicio de extracción de texto está bien configurado.
Nota: El Extractor de texto local admite el coreano a partir de la versión
v1.4.0. Si usas una versión anterior, actualiza la aplicación para reconocer texto en coreano.
- Haz clic en Extraer resumen de imagen. Una marca de verificación en el icono confirma que el modelo de Extraer resumen de imagen está bien configurado.
- Haz clic en Traducir todos los bloques de texto. Si se generan traducciones, el modelo de traducción está bien configurado.
Fuente del cómic: Say Hello to Black Jack, de Shuho Sato.
Procesamiento por lotes
Sección titulada «Procesamiento por lotes»Cuando hayas confirmado que la configuración funciona, elige las imágenes y los pasos automatizados que quieres ejecutar.
- Haz clic en el icono ✨ para abrir Procesamiento por lotes. De forma predeterminada, se seleccionan todas las imágenes del capítulo actual; elige los pasos automatizados que quieres ejecutar.
- Selecciona los pasos que necesites, haz clic en Iniciar y espera a que termine el procesamiento. El análisis de imagen es opcional; úsalo cuando las descripciones de las imágenes sirvan como contexto para la traducción.
Consejo: La configuración actual usa el Detector local de bloques de texto. Este encuentra las regiones de texto, pero no extrae su contenido. Ejecuta Extraer texto de los bloques de texto cuando necesites rellenar el texto original. El análisis de imagen es opcional.
Modelos como PaddleOCR VL 1.6 también pueden devolver el texto reconocido durante la detección. De forma predeterminada, el paso independiente de extracción de texto solo rellena los bloques de texto cuyo texto original está vacío; elige el alcance Todas las imágenes solo si quieres volver a ejecutar la extracción sobre el texto existente.
Flujo automatizado y modelos
Sección titulada «Flujo automatizado y modelos»El flujo de traducción de cómics consta de cuatro etapas:
- Detectar bloques de texto encuentra las regiones de texto y crea bloques de texto. Algunos modelos también ejecutan Extraer texto durante la detección.
- Extraer texto lee el texto de la imagen y lo guarda como texto original en cada bloque de texto. Requiere un modelo multimodal con capacidad de visión o un modelo de OCR dedicado.
- Extraer resumen de imagen (opcional) describe con texto el contenido de la imagen para aportar contexto a la traducción. Requiere un modelo multimodal con capacidad de visión.
- Traducir usa ese contexto para traducir el texto original de los bloques de texto detectados. Requiere un modelo de lenguaje grande.
Estas etapas corresponden a los botones de automatización del editor de cómics. Las acciones disponibles dependen de las capacidades de los modelos configurados en Perfiles de servicio:

IA genérica se conecta a API de modelos de lenguaje grandes:
- Los modelos de IA genérica pueden Traducir.
- Los modelos con capacidad de visión también pueden Extraer texto y Extraer resumen de imagen.
Detectar bloques de texto requiere modelos con compatibilidad específica. Las opciones compatibles actualmente son:
- Detector local de bloques de texto: descarga el modelo para encontrar regiones de texto en las páginas de cómic. Funciona sin conexión y es gratuito. Se necesita otro modelo para extraer el texto. Es la opción recomendada.
- PaddleOCR VL 1.6: requiere una API y también puede extraer texto durante la detección.
- GLM-OCR: requiere una API y también puede extraer texto durante la detección.
Extraer texto también cuenta con una opción integrada específicamente:
- Extractor de texto local: descarga el modelo para extraer texto directamente en el dispositivo. Funciona sin conexión y es gratuito.
Obtener ayuda
Sección titulada «Obtener ayuda»Si tienes problemas con la configuración o quieres hacer sugerencias, únete a la conversación de la comunidad en Discord.