
Guia de início rápido
O Neko Translator é um assistente com IA para traduzir quadrinhos e mangás.
Seja você um leitor que traduz quadrinhos em língua estrangeira ou um tradutor profissional, pode usá-lo como plataforma para o seu trabalho de tradução.
Este guia mostra a instalação, a configuração e a conexão com APIs de modelos online.
Uma observação sobre o uso de tokens
Seção intitulada “Uma observação sobre o uso de tokens”O Neko Translator em si é gratuito, mas as APIs de modelos de terceiros às quais ele se conecta podem cobrar pelo uso. Em nossos testes, trabalhos de tradução típicos não custam muito:
- Com o gemma4-31b-it da OpenRouter como modelo de visão (raciocínio desativado), reconhecer cerca de 1.000 caixas de texto/imagens custa aproximadamente US$ 0,089.
- Com o deepseek-v4-flash da API oficial da DeepSeek (raciocínio ativado), traduzir 50 páginas de quadrinhos custa cerca de US$ 0,074.
- Se você tiver uma GPU potente, conectar um modelo local também é uma boa forma de evitar esses custos.
Observação: faça primeiro uma pequena tradução de teste e acompanhe o seu uso de tokens para não ter cobranças inesperadas. Se o seu provedor permitir, também recomendamos definir um limite de gastos na chave de API.
Instalar o Neko Translator
Seção intitulada “Instalar o Neko Translator”Acesse o nosso site em um navegador para baixar o Neko Translator.
Configurar os serviços
Seção intitulada “Configurar os serviços”Este guia recomenda e usa google/gemma-4-31b-it como modelo de visão e deepseek/deepseek-v4-flash com raciocínio ativado como modelo de tradução.
google/gemma-4-31b-it é uma opção de baixo custo que lida bem com Extrair texto, mas seus resumos de imagem são apenas medianos. Se você depende de Extrair resumo da imagem como contexto para a tradução, considere um modelo de visão mais capaz; consulte Configuração de serviço: IA genérica.
Criar uma conta e uma chave de API na OpenRouter
Seção intitulada “Criar uma conta e uma chave de API na OpenRouter”- Acesse a OpenRouter e entre ou crie uma conta.
- Se você pretende usar modelos pagos, adicione créditos na página Credits.
- Abra a página Keys e selecione Create Key.
- Dê à chave um nome fácil de reconhecer, crie-a, depois copie a chave e guarde-a em um lugar seguro. Você só precisará colá-la no Neko Translator uma vez.
Configurar a IA genérica
Seção intitulada “Configurar a IA genérica”Volte ao Neko Translator e abra Perfis de serviço.
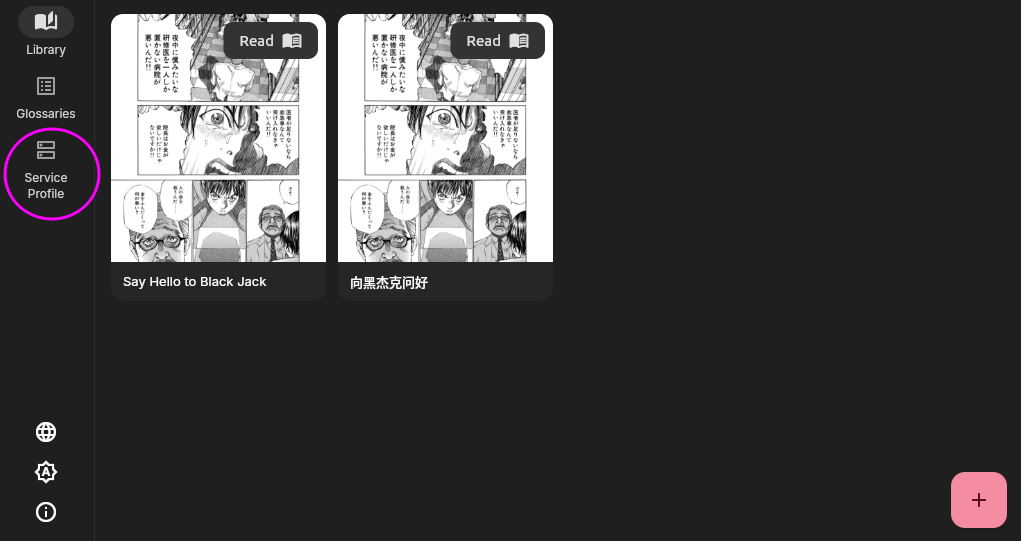
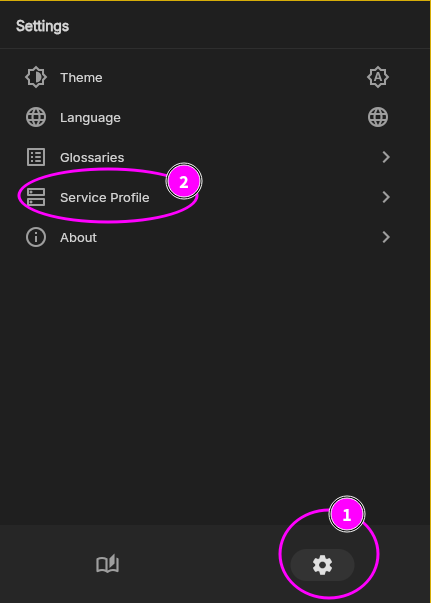
Primeiro, configure a API da OpenRouter:
- Em API de IA geral, selecione + Adicionar e escolha OpenRouter.
- Cole a chave de API que começa com
ske que você copiou antes. - Não altere a predefinição de modelo que já vem configurada.
- Salve o perfil.
Configurar os modelos locais
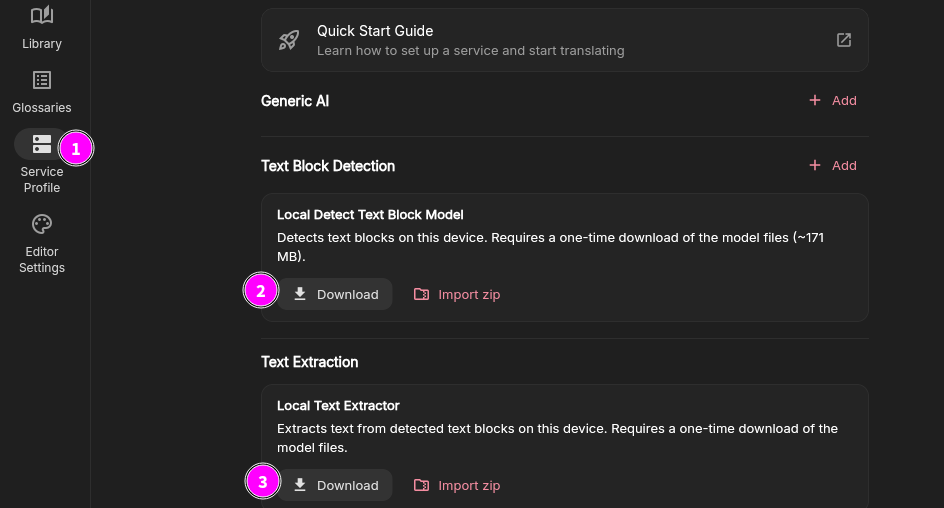
Seção intitulada “Configurar os modelos locais”- Abra Perfis de serviço.
- Em Detecção de blocos de texto, encontre Modelo local de detecção de blocos de texto e selecione Baixar.
- Em Extração de texto, encontre Extrator de texto local e selecione Baixar. Comece com o modelo Medium. Se ele ficar lento, mude para uma versão menor.
Você também pode baixar esses modelos de outras fontes, como a página inicial do Neko Translator. Selecione Importar zip para importar um arquivo compactado de modelo.
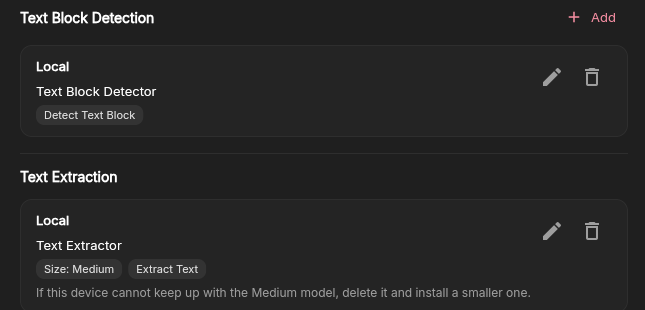
- Após a configuração, o detector de blocos de texto local e o extrator de texto devem aparecer como mostrado abaixo.
Testar a configuração
Seção intitulada “Testar a configuração”Depois de configurar, teste se cada etapa funciona como esperado:
- Adicione um quadrinho e envie uma ou mais páginas.
- Clique em Detectar blocos de texto na imagem. Quando as caixas de texto aparecerem, o serviço de detecção de blocos de texto estará configurado corretamente.
-
Clique em Extrair texto dos blocos de texto. Quando o texto aparecer nos blocos de texto, o serviço de extração de texto estará configurado corretamente.
Observação: o Extrator de texto local é compatível com coreano a partir da versão
v1.4.0. Se você usa uma versão anterior, atualize o aplicativo para reconhecer coreano.
- Clique em Extrair resumo da imagem. Uma marca de seleção no ícone confirma que o modelo de Extrair resumo da imagem está configurado corretamente.
- Clique em Traduzir todos os blocos de texto. Se as traduções forem geradas, o modelo de tradução estará configurado corretamente.
Fonte do quadrinho: Say Hello to Black Jack, de Shuho Sato.
Processamento em lote
Seção intitulada “Processamento em lote”Depois de confirmar que a configuração funciona, escolha as imagens e as etapas de automação que deseja executar.
- Clique no ícone ✨ para abrir Processamento em lote. Por padrão, todas as imagens do capítulo atual ficam selecionadas; escolha as etapas de automação que deseja executar.
- Selecione as etapas necessárias, clique em Iniciar e aguarde o fim do processamento. A análise de imagem é opcional; use-a quando descrições das imagens forem úteis como contexto para a tradução.
Dica: a configuração atual usa o Detector de blocos de texto local. Ele encontra as regiões de texto, mas não extrai o texto delas. Execute Extrair texto dos blocos de texto quando precisar preencher o texto original. A análise de imagem é opcional.
Modelos como o PaddleOCR VL 1.6 também podem retornar o texto reconhecido durante a detecção. Por padrão, a etapa separada de extração de texto preenche apenas os blocos de texto cujo texto original está vazio; escolha o escopo Todas as imagens somente quando quiser executar a extração novamente sobre o texto existente.
Fluxo de trabalho automatizado e modelos
Seção intitulada “Fluxo de trabalho automatizado e modelos”O fluxo de tradução de quadrinhos tem quatro etapas:
- Detectar blocos de texto encontra as regiões de texto e cria os blocos de texto. Alguns modelos também executam Extrair texto durante a detecção.
- Extrair texto lê o texto da imagem e o salva como texto original de cada bloco de texto. Isso exige um modelo multimodal com visão ou um modelo de OCR dedicado.
- Extrair resumo da imagem (opcional) descreve o conteúdo da imagem em texto para fornecer contexto à tradução. Isso exige um modelo multimodal com visão.
- Traduzir usa esse contexto para traduzir o texto original dos blocos de texto detectados. Isso exige um modelo de linguagem de grande porte (LLM).
Essas etapas correspondem aos botões de automação do editor de quadrinhos. As ações disponíveis dependem das capacidades dos modelos configurados em Perfis de serviço:

IA genérica se conecta a APIs de modelos de linguagem de grande porte:
- Os modelos de IA genérica podem Traduzir.
- Modelos com capacidade de visão também podem Extrair texto e Extrair resumo da imagem.
Detectar blocos de texto exige modelos com suporte específico. As opções atualmente compatíveis são:
- Detector de blocos de texto local: baixe o modelo para encontrar regiões de texto nas páginas dos quadrinhos. Funciona offline e é gratuito. É necessário outro modelo para extrair o texto. Esta é a opção recomendada.
- PaddleOCR VL 1.6: exige uma API e também pode extrair o texto durante a detecção.
- GLM-OCR: exige uma API e também pode extrair o texto durante a detecção.
Extrair texto também conta com uma opção de integração dedicada:
- Extrator de texto local: baixe o modelo para extrair o texto diretamente no dispositivo. Funciona offline e é gratuito.
Obter ajuda
Seção intitulada “Obter ajuda”Se você tiver problemas de configuração ou sugestões, participe da discussão da comunidade no Discord.