
Руководство по быстрому старту
Neko Translator — это ИИ-помощник для перевода комиксов и манги.
Читаете ли вы комиксы на иностранном языке или работаете профессиональным переводчиком — вы можете использовать его как платформу для своей переводческой работы.
Это руководство проведёт вас через установку, настройку и подключение к API онлайн-моделей.
Об использовании токенов
Заголовок раздела «Об использовании токенов»Сам Neko Translator бесплатен, но сторонние API моделей, к которым он подключается, могут быть платными. По нашим тестам, типичные задачи перевода стоят недорого:
- С моделью gemma4-31b-it от OpenRouter в качестве визуальной модели (рассуждение отключено) распознавание около 1000 текстовых рамок/изображений стоит примерно 0,089 доллара США.
- С моделью deepseek-v4-flash через официальный API DeepSeek (рассуждение включено) перевод 50 страниц комикса стоит примерно 0,074 доллара США.
- Если у вас мощная видеокарта, подключение локальной модели — тоже хороший способ избежать этих расходов.
Примечание. Сначала выполните небольшой пробный перевод и следите за расходом токенов, чтобы избежать неожиданных списаний. Если провайдер это поддерживает, также рекомендуем установить лимит расходов для API-ключа.
Установка Neko Translator
Заголовок раздела «Установка Neko Translator»Откройте наш сайт в браузере, чтобы скачать Neko Translator.
Настройка сервисов
Заголовок раздела «Настройка сервисов»В этом руководстве рекомендуется и используется google/gemma-4-31b-it в качестве визуальной модели и deepseek/deepseek-v4-flash с включённым рассуждением в качестве модели перевода.
google/gemma-4-31b-it — недорогой вариант, который хорошо справляется с задачей Извлечь текст, но описания изображений у него лишь посредственные. Если вы полагаетесь на шаг Извлечь описание изображения как на источник контекста для перевода, выберите более мощную визуальную модель; см. Настройка сервисов: универсальный ИИ.
Создание аккаунта и API-ключа OpenRouter
Заголовок раздела «Создание аккаунта и API-ключа OpenRouter»- Перейдите на OpenRouter и войдите или создайте аккаунт.
- Если вы планируете использовать платные модели, пополните баланс на странице Credits.
- Откройте страницу Keys и нажмите Create Key.
- Дайте ключу узнаваемое имя, создайте его, затем скопируйте ключ и сохраните в надёжном месте. Вставить его в Neko Translator понадобится только один раз.
Настройка универсального ИИ
Заголовок раздела «Настройка универсального ИИ»Вернитесь в Neko Translator и откройте Профили сервисов.
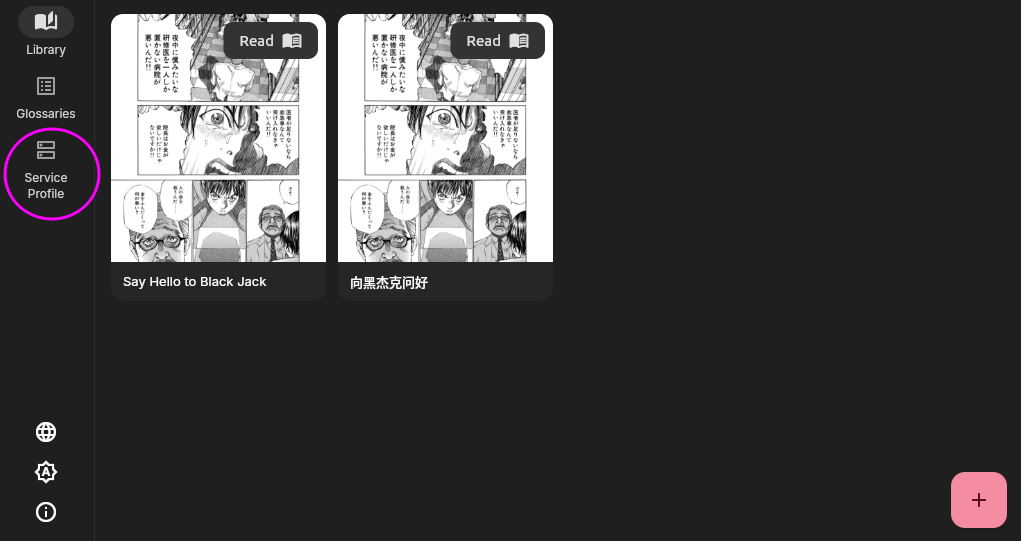
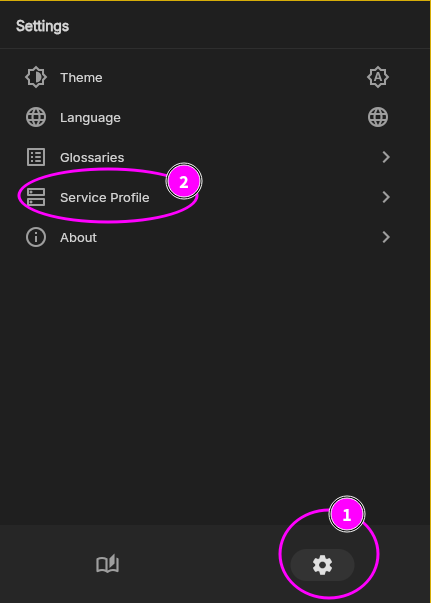
Сначала настройте API OpenRouter:
- В разделе API универсального ИИ нажмите + Добавить и выберите OpenRouter.
- Вставьте скопированный ранее API-ключ, начинающийся с
sk. - Оставьте предустановленный набор моделей без изменений.
- Сохраните профиль.
Настройка локальных моделей
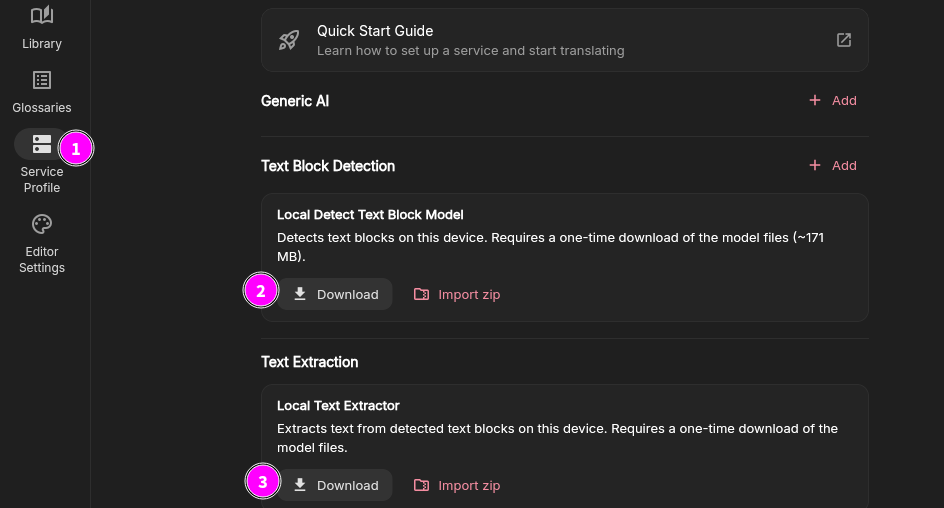
Заголовок раздела «Настройка локальных моделей»- Откройте Профили сервисов.
- В разделе Обнаружение текстовых блоков найдите Локальная модель обнаружения текстовых блоков и нажмите Скачать.
- В разделе Извлечение текста найдите Локальный экстрактор текста и нажмите Скачать. Начните со средней модели (Medium). Если она работает медленно, перейдите на версию поменьше.
Эти модели также можно скачать из других источников, например с главной страницы Neko Translator. Нажмите Импортировать zip, чтобы импортировать архив модели.
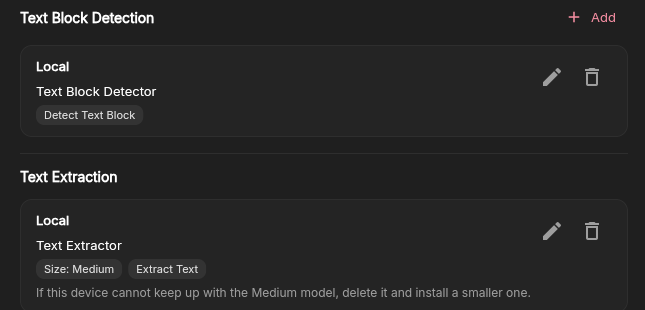
- После настройки локальный детектор текстовых блоков и экстрактор текста должны выглядеть, как показано ниже.
Проверка настройки
Заголовок раздела «Проверка настройки»После настройки проверьте, что каждый этап работает как ожидается:
- Добавьте комикс, затем загрузите одну или несколько страниц.
- Нажмите Обнаружить текстовые блоки на изображении. Если появились текстовые рамки, сервис обнаружения текстовых блоков настроен правильно.
-
Нажмите Извлечь текст из текстовых блоков. Если в текстовых блоках появился текст, сервис извлечения текста настроен правильно.
Примечание. Локальный экстрактор текста поддерживает корейский язык начиная с версии
v1.4.0. Если вы используете более раннюю версию, обновите приложение, чтобы распознавать корейский текст.
- Нажмите Извлечь описание изображения. Галочка на значке подтверждает, что модель для шага Извлечь описание изображения настроена правильно.
- Нажмите Перевести все текстовые блоки. Если переводы созданы, модель перевода настроена правильно.
Источник комикса: Say Hello to Black Jack, автор Сюхо Сато.
Пакетная обработка
Заголовок раздела «Пакетная обработка»Убедившись, что настройка работает, выберите изображения и шаги автоматизации, которые нужно выполнить.
- Нажмите значок ✨, чтобы открыть окно Пакетная обработка. По умолчанию выбраны все изображения текущей главы; выберите шаги автоматизации, которые нужно выполнить.
- Отметьте нужные шаги, затем нажмите Начать и дождитесь окончания обработки. Анализ изображений необязателен; используйте его, когда описания изображений полезны как контекст для перевода.
Совет. В текущей настройке используется локальный детектор текстовых блоков. Он находит области с текстом, но не извлекает из них текст. Запустите Извлечь текст из текстовых блоков, когда нужно заполнить исходный текст. Анализ изображений необязателен.
Модели вроде PaddleOCR VL 1.6 могут возвращать распознанный текст уже при обнаружении. По умолчанию отдельный шаг извлечения текста заполняет только текстовые блоки с пустым исходным текстом; выбирайте область Все изображения, только если действительно хотите заново извлечь уже существующий текст.
Автоматизированный процесс и модели
Заголовок раздела «Автоматизированный процесс и модели»Процесс перевода комикса состоит из четырёх этапов:
- Обнаружить текстовые блоки — находит области с текстом и создаёт текстовые блоки. Некоторые модели при обнаружении также выполняют шаг Извлечь текст.
- Извлечь текст — считывает текст с изображения и сохраняет его как исходный текст каждого текстового блока. Для этого нужна мультимодальная модель с поддержкой изображений или специальная модель OCR.
- Извлечь описание изображения (необязательно) — описывает содержимое изображения текстом, чтобы дать контекст для перевода. Для этого нужна мультимодальная модель с поддержкой изображений.
- Перевести — использует этот контекст для перевода исходного текста в обнаруженных текстовых блоках. Для этого нужна большая языковая модель.
Эти этапы соответствуют кнопкам автоматизации в редакторе комиксов. Доступные действия зависят от возможностей моделей, настроенных в разделе Профили сервисов:

Универсальный ИИ подключается к API больших языковых моделей:
- Модели универсального ИИ поддерживают возможность Перевести.
- Модели с поддержкой изображений также поддерживают возможности Извлечь текст и Извлечь описание изображения.
Для возможности Обнаружить текстовые блоки нужны специально поддерживаемые модели. Сейчас поддерживаются:
- Локальный детектор текстовых блоков: скачайте модель, чтобы находить области с текстом на страницах комиксов. Работает офлайн и бесплатно. Для извлечения текста нужна отдельная модель. Это рекомендуемый вариант.
- PaddleOCR VL 1.6: требует API и может извлекать текст при обнаружении.
- GLM-OCR: требует API и может извлекать текст при обнаружении.
Для возможности Извлечь текст тоже есть специально интегрированный вариант:
- Локальный экстрактор текста: скачайте модель, чтобы извлекать текст прямо на устройстве. Работает офлайн и бесплатно.
Получение помощи
Заголовок раздела «Получение помощи»Если у вас возникли проблемы с настройкой или есть предложения, присоединяйтесь к обсуждению в сообществе Discord.