
快速入門指南
Neko Translator 是一款以 AI 驅動的漫畫翻譯助手。
無論你是想翻譯外文漫畫的讀者,還是專業譯者,都可以把它當作翻譯工作的平台。
本指南將帶你完成安裝、設定,以及連接線上模型 API。
關於 token 用量
Section titled “關於 token 用量”Neko Translator 本身免費,但它所連接的第三方模型 API 可能會向你收費。根據我們的測試,一般的翻譯工作花費並不高:
- 使用 OpenRouter 上的 gemma4-31b-it 作為視覺模型(停用推理),辨識約 1,000 個文字框/圖片的花費約為 0.089 美元。
- 使用 DeepSeek 官方 API 的 deepseek-v4-flash(啟用推理),翻譯 50 頁漫畫的花費約為 0.074 美元。
- 如果你有效能強大的 GPU,連接本機模型也是避免這些費用的好方法。
注意:請先進行小規模的試譯,並留意 token 用量,以免產生意料之外的費用。如果你的供應商支援,我們也建議為 API Key 設定消費上限。
安裝 Neko Translator
Section titled “安裝 Neko Translator”使用瀏覽器前往我們的網站下載 Neko Translator。
本指南推薦並使用 google/gemma-4-31b-it 作為視覺模型,以及啟用推理的 deepseek/deepseek-v4-flash 作為翻譯模型。
google/gemma-4-31b-it 是低成本的選擇,擷取文字的表現不錯,但圖片摘要的品質只算普通。如果你仰賴擷取圖片摘要提供翻譯上下文,可以考慮能力更強的視覺模型;請參閱服務設定:通用 AI。
建立 OpenRouter 帳號與 API Key
Section titled “建立 OpenRouter 帳號與 API Key”- 前往 OpenRouter,登入或建立帳號。
- 如果打算使用付費模型,請在 Credits 頁面儲值。
- 開啟 Keys 頁面,選擇 Create Key。
- 為金鑰取一個容易辨識的名稱並建立,然後複製金鑰並妥善保存。你只需要將它貼到 Neko Translator 一次。
設定通用 AI
Section titled “設定通用 AI”回到 Neko Translator,開啟服務設定檔。
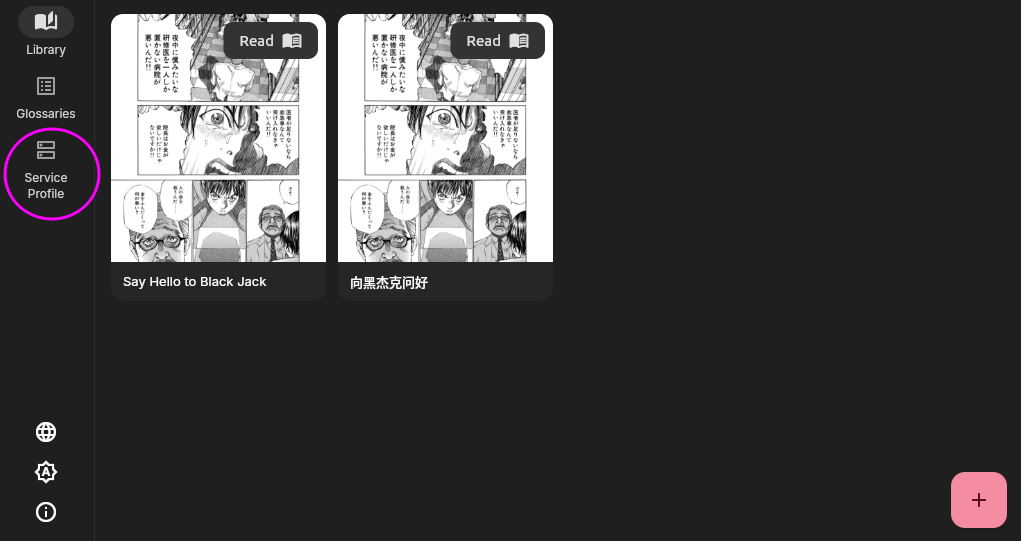
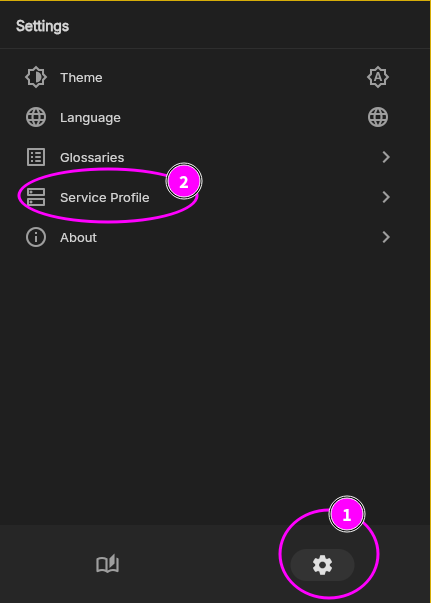
首先,設定 OpenRouter API:
- 在通用 AI API 下方選擇 + 新增,然後選擇 OpenRouter。
- 貼上先前複製、以
sk開頭的 API Key。 - 保留預先設定好的模型預設組合,不要變更。
- 儲存設定檔。
設定本機模型
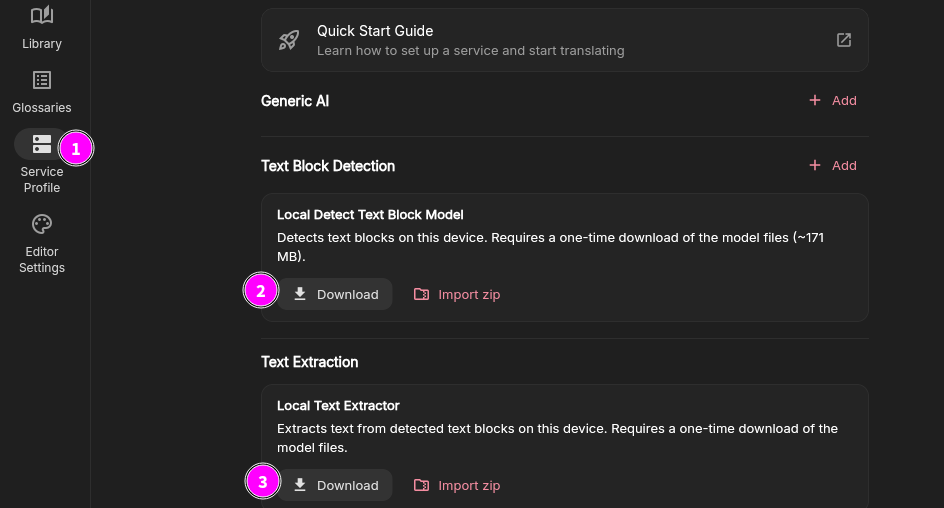
Section titled “設定本機模型”- 開啟服務設定檔。
- 在文字區塊偵測下方找到本機文字區塊偵測模型,選擇下載。
- 在文字擷取下方找到本機文字擷取器,選擇下載。建議先從 Medium 模型開始;如果執行速度太慢,再改用較小的版本。
你也可以從其他來源下載這些模型,例如 Neko Translator 首頁。選擇匯入 zip 即可匯入模型壓縮檔。
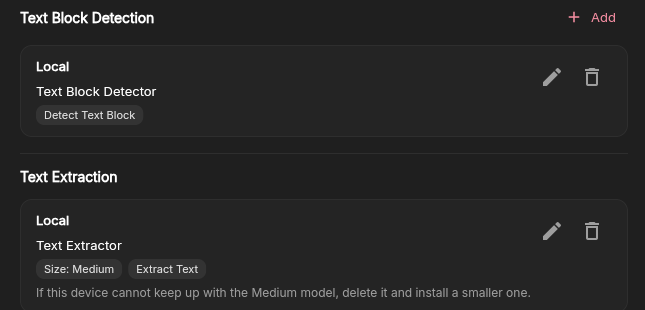
- 設定完成後,本機文字區塊偵測器與文字擷取器應如下圖所示。
設定完成後,測試每個階段是否如預期運作:
- 新增一部漫畫,然後上傳一頁或多頁漫畫圖片。
- 點選偵測圖片中的文字區塊。出現文字框時,代表文字區塊偵測服務設定正確。
-
點選從文字區塊擷取文字。文字區塊中出現文字時,代表文字擷取服務設定正確。
注意:本機文字擷取器自
v1.4.0版起已支援韓文。如果您使用的是先前的版本,請升級後再辨識韓文。
- 點選擷取圖片摘要。圖示上出現勾號,即代表擷取圖片摘要所用的模型設定正確。
- 點選翻譯所有文字區塊。如果產生了譯文,代表翻譯模型設定正確。
漫畫來源:佐藤秀峰《向黑傑克致敬》(Say Hello to Black Jack)。
確認設定可以正常運作後,選擇要處理的圖片與要執行的自動化步驟。
- 點選 ✨ 圖示開啟批次處理。預設會選取目前章節中的所有圖片;接著選擇要執行的自動化步驟。
- 選取需要的步驟,點選開始,然後等待處理完成。圖片解析為選用步驟;當圖片描述有助於提供翻譯上下文時再使用。
提示:目前的設定使用本機文字區塊偵測器。它會找出文字區域,但不會擷取其中的文字。需要填入原文時,請執行從文字區塊擷取文字。圖片解析為選用步驟。
PaddleOCR VL 1.6 等模型也能在偵測時一併回傳辨識出的文字。預設情況下,獨立的文字擷取步驟只會填入原文為空的文字區塊;只有在確定要對既有文字重新擷取時,才選擇所有圖片範圍。
自動化工作流程與模型
Section titled “自動化工作流程與模型”漫畫翻譯工作流程包含四個階段:
- 偵測文字區塊會找出文字區域並建立文字區塊。部分模型也會在偵測時擷取文字。
- 擷取文字會從圖片中讀取文字,並儲存為各文字區塊的原文。這需要具備視覺能力的多模態模型,或專用的 OCR 模型。
- 擷取圖片摘要(選用)會以文字描述圖片內容,為翻譯提供上下文。這需要具備視覺能力的多模態模型。
- 翻譯會運用這些上下文,翻譯已偵測文字區塊中的原文。這需要大型語言模型。
這些階段對應到漫畫編輯器中的自動化按鈕。可用的操作取決於服務設定檔中所設定模型的能力:

通用 AI 用來連接大型語言模型 API:
- 通用 AI 模型可以翻譯。
- 具備視覺能力的模型還可以擷取文字與擷取圖片摘要。
偵測文字區塊需要經過特別支援的模型。目前支援的選項有:
- 本機文字區塊偵測器:下載模型後,即可找出漫畫頁面上的文字區域。可離線運作,免費使用。需要另一個模型來擷取文字。這是推薦的選項。
- PaddleOCR VL 1.6:需要 API,並可在偵測時一併擷取文字。
- GLM-OCR:需要 API,並可在偵測時一併擷取文字。
擷取文字也有一個特別整合的選項:
- 本機文字擷取器:下載模型後,即可直接在裝置上擷取文字。可離線運作,免費使用。
如果遇到設定問題或有任何建議,歡迎加入 Discord 社群參與討論。