
用語集
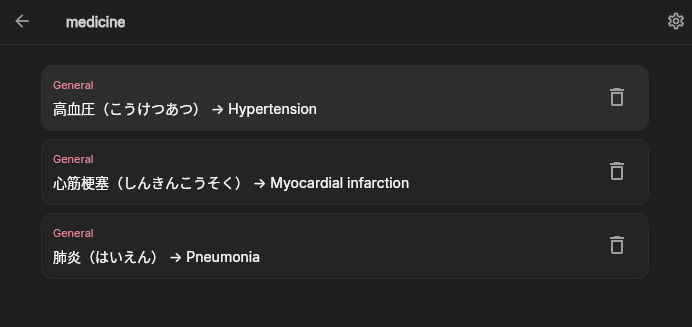
用語集の役割
Section titled “用語集の役割”用語集は、人名、地名、組織名、スキル、繰り返し登場する表現について、優先して使う訳語を翻訳モデルに伝えるものです。
ブランド名など翻訳してはいけない用語や、訳文に決して含めてはいけない語句を指定することもできます。
用語集はモデルに与えるコンテキストであり、文字列の置換を保証する仕組みではありません。重要な用語は、翻訳結果で確認してください。
用語集を作成する
Section titled “用語集を作成する”- 設定 → 用語集を開きます。
- 用語集を作成し、名前を付けます。
- 原語と訳語を追加します。
- 各エントリを保存します。
グローバルな用語集は、複数の漫画で再利用できます。漫画設定から用語集の作成・編集ページに直接移動することもできます。
用語集を適用する
Section titled “用語集を適用する”漫画設定の用語集セクションで、既存の用語集を現在の漫画に適用します。複数の用語集を適用できます。
同じ原語を複数の用語集で異なる訳語に定義しないでください。矛盾するエントリがある場合、最終的な結果はその順序とモデルの判断によって決まります。
漫画設定で原文で一致した場合のみプロンプトに追加を有効にすると、現在のページの原文に出現する用語だけがプロンプトに追加されます。無効の場合は、漫画に適用されているすべての用語集がプロンプトに含まれます。用語が多い場合、この設定でプロンプトを短く保てます。これはモデルに送信するコンテキストを絞り込むもので、原文や訳文を置き換えるものではありません。
インポートとエクスポート
Section titled “インポートとエクスポート”設定 → 用語集のインポート・エクスポート操作を使います。
.gls.neko、.zip、.neko、CSV、JSON ファイルをインポートできます。アーカイブが完全なプロジェクトパッケージの場合は、その用語集だけを抽出できます。用語集を含まない通常の ZIP からは何もインポートされません。CSV/JSON のインポートでは、フィールドの対応付けとプレビューの手順があります。CSV の場合は、1 行目をヘッダーとして扱うかどうかを選びます。区切り文字は自動的に検出されます。JSON は、トップレベルの配列、またはトップレベルのオブジェクト内の配列プロパティを受け付けます。- デフォルトでは、同じ名前(大文字と小文字は区別しない)の用語集が統合の対象として対応付けられます。対応付けられなかった用語集は新しい用語集として作成されます。インポートする前に、矛盾する各エントリについて、取り込む値とローカルの値のどちらを使うかを選んで解決してください。上書きすると、ローカルにのみ存在するエントリやローカルで変更したエントリも含めて、対象の用語集のエントリが置き換えられます。それらのエントリを残したい場合は、上書きを選ばないでください。
- CSV/JSON のテキストは UTF-8 として読み込まれます。ファイルが別のエンコーディングの場合、プレビューで ASCII 以外の文字が文字化けすることがあります。インポートする前に、ファイルが UTF-8 であることを確認してください。
- 1 つ以上の用語集を選択して、
.gls.nekoパッケージとしてエクスポートできます。これには用語集のデータが含まれ、漫画の画像は含まれません。この形式は異なる環境の Neko Translator 間で用語集を移すためのもので、漫画プロジェクトのデータを含む.nekoプロジェクトパッケージとは異なります。
漫画プロジェクトをエクスポートするときに、適用されている用語集を含めるかどうかも選べます。プロジェクトのインポートとエクスポートを参照してください。
用語集の変更は、以降のリクエストに反映されます。既存の原文や訳文は書き換えられません。更新した用語を使いたいボックスについては翻訳を再実行し、処理範囲は慎重に選んでください。
用語集を削除したり適用を解除したりしても、漫画の画像、テキストブロック、既存の訳文は削除されません。