
クイックスタートガイド
Neko Translator は、漫画やコミックの翻訳を支援する AI アシスタントです。
外国語の漫画を翻訳して読みたい読者の方にも、プロの翻訳者の方にも、翻訳作業のプラットフォームとしてお使いいただけます。
このガイドでは、インストール、設定、オンラインモデル API への接続までを順に説明します。
トークン使用量について
Section titled “トークン使用量について”Neko Translator 自体は無料ですが、接続するサードパーティのモデル API は有料の場合があります。私たちのテストでは、一般的な翻訳作業にかかる費用はそれほど高くありません。
- OpenRouter の gemma4-31b-it を画像認識モデルとして使用した場合(推論は無効)、約 1,000 個のテキストボックス/画像の認識にかかる費用は約 0.089 米ドルでした。
- DeepSeek 公式 API の deepseek-v4-flash を使用した場合(推論は有効)、漫画 50 ページの翻訳にかかる費用は約 0.074 米ドルでした。
- 高性能な GPU をお持ちの場合は、ローカルモデルに接続するのもこうした費用を避けるよい方法です。
注: 想定外の請求が発生しないよう、まずは小規模なテスト翻訳を行い、トークン使用量に注意してください。プロバイダーが対応している場合は、API キーに利用上限を設定することもおすすめします。
Neko Translator をインストールする
Section titled “Neko Translator をインストールする”ブラウザーで公式サイトにアクセスし、Neko Translator をダウンロードします。
サービスを設定する
Section titled “サービスを設定する”このガイドでは、画像認識モデルとして google/gemma-4-31b-it を、翻訳モデルとして推論を有効にした deepseek/deepseek-v4-flash を推奨し、使用します。
google/gemma-4-31b-it は低コストでテキストを抽出の処理を得意としますが、生成される画像の要約の品質はそれほど高くありません。翻訳のコンテキストとして画像の要約を抽出の結果を活用したい場合は、より高性能な画像認識モデルを検討してください。サービス設定:汎用 AI を参照してください。
OpenRouter のアカウントと API キーを作成する
Section titled “OpenRouter のアカウントと API キーを作成する”- OpenRouter にアクセスし、サインインするかアカウントを作成します。
- 有料モデルを使う予定がある場合は、Credits ページでクレジットを追加します。
- Keys ページを開き、Create Key を選択します。
- キーにわかりやすい名前を付けて作成し、キーをコピーして安全な場所に保管します。Neko Translator に貼り付けるのは一度だけです。
汎用 AI を設定する
Section titled “汎用 AI を設定する”Neko Translator に戻り、サービスプロファイルを開きます。
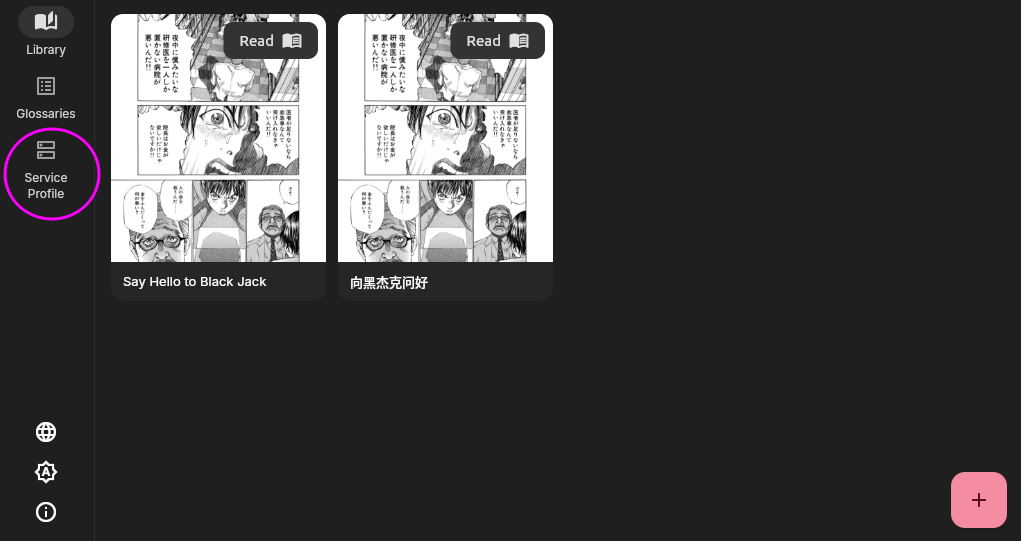
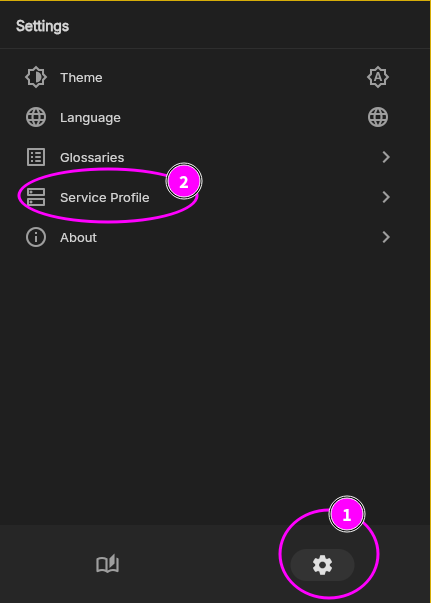
まず、OpenRouter API を設定します。
- 汎用 AI API で + 追加を選択し、OpenRouter を選びます。
- 先ほどコピーした
skで始まる API キーを貼り付けます。 - あらかじめ設定されているモデルプリセットはそのままにします。
- プロファイルを保存します。
ローカルモデルを設定する
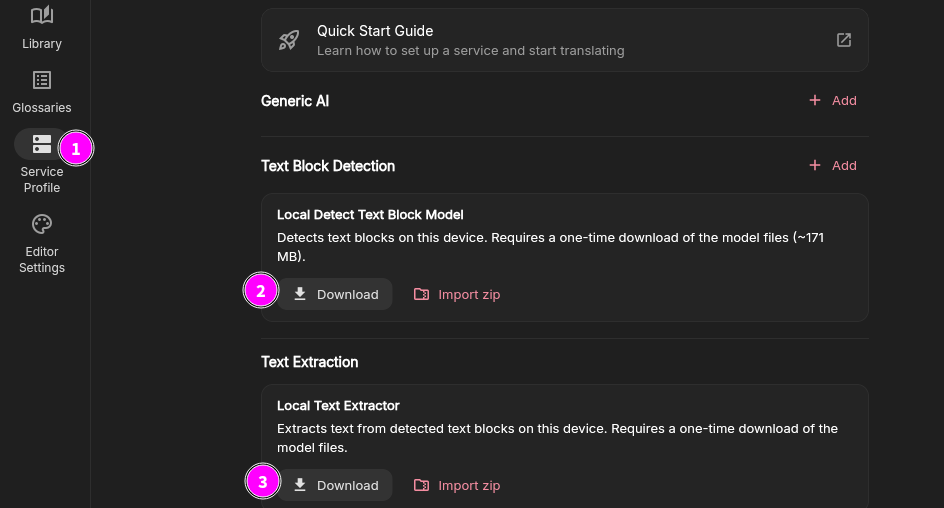
Section titled “ローカルモデルを設定する”- サービスプロファイルを開きます。
- テキストブロック検出でローカルテキストブロック検出モデルを見つけ、ダウンロードを選択します。
- テキスト抽出でローカルテキスト抽出器を見つけ、ダウンロードを選択します。まずは Medium モデルから始め、動作が遅い場合はより小さいバージョンに切り替えてください。
これらのモデルは、Neko Translator のホームページなど、ほかの入手先からダウンロードすることもできます。モデルのアーカイブをインポートするには、zip をインポートを選択します。
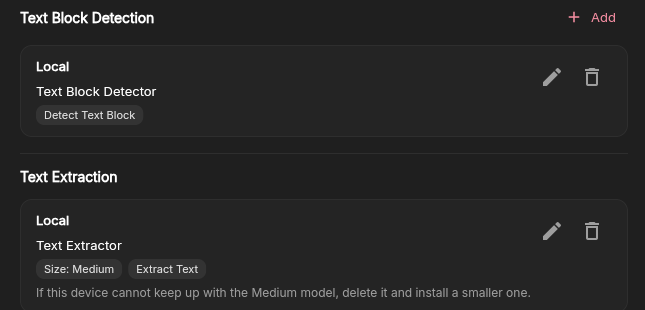
- 設定が完了すると、ローカルテキストブロック検出器とテキスト抽出器が下図のように表示されます。
設定をテストする
Section titled “設定をテストする”設定が終わったら、各段階が想定どおりに動作するかテストします。
- 漫画を追加し、漫画のページを 1 枚以上アップロードします。
- 画像内のテキストブロックを検出をクリックします。テキストボックスが表示されれば、テキストブロック検出サービスは正しく設定されています。
-
テキストブロックからテキストを抽出をクリックします。テキストブロックにテキストが表示されれば、テキスト抽出サービスは正しく設定されています。
注: ローカルテキスト抽出器はバージョン
v1.4.0から韓国語に対応しています。それ以前のバージョンで韓国語を認識するには、アップグレードしてください。
- 画像の要約を抽出をクリックします。アイコンにチェックマークが付けば、画像の要約を抽出用のモデルは正しく設定されています。
- すべてのテキストブロックを翻訳をクリックします。訳文が生成されれば、翻訳モデルは正しく設定されています。
漫画の出典:佐藤秀峰『ブラックジャックによろしく』
設定が正しく動作することを確認したら、実行したい画像と自動化ステップを選びます。
- ✨ アイコンをクリックして一括処理を開きます。デフォルトでは現在の章のすべての画像が選択されています。実行したい自動化ステップを選んでください。
- 必要なステップを選択し、開始をクリックして処理が終わるまで待ちます。画像の解析は任意です。画像の説明が翻訳のコンテキストとして役立つ場合に使用してください。
ヒント: 現在の設定ではローカルテキストブロック検出器を使用しています。これはテキスト領域を見つけますが、テキストは抽出しません。原文を入力する必要がある場合は、テキストブロックからテキストを抽出を実行してください。画像の解析は任意です。
PaddleOCR VL 1.6 などのモデルは、検出時に認識したテキストも返すことができます。デフォルトでは、個別のテキスト抽出ステップは原文が空のテキストブロックだけを処理します。既存のテキストに対して抽出をやり直したい場合にのみ、すべての画像の範囲を選択してください。
自動ワークフローとモデル
Section titled “自動ワークフローとモデル”漫画翻訳のワークフローは 4 つの段階で構成されています。
- テキストブロックを検出は、テキスト領域を見つけてテキストブロックを作成します。一部のモデルは検出時にテキストを抽出も行います。
- テキストを抽出は、画像からテキストを読み取り、各テキストブロックの原文として保存します。画像を認識できるマルチモーダルモデル、または専用の OCR モデルが必要です。
- 画像の要約を抽出(任意)は、画像の内容をテキストで説明し、翻訳のコンテキストを提供します。画像を認識できるマルチモーダルモデルが必要です。
- 翻訳は、そのコンテキストを使って、検出されたテキストブロックの原文を翻訳します。大規模言語モデルが必要です。
これらの段階は、漫画エディターの自動化ボタンに対応しています。使用できる操作は、サービスプロファイルで設定したモデルの機能によって決まります。

汎用 AI は大規模言語モデルの API に接続します。
- 汎用 AI モデルは翻訳ができます。
- 画像認識機能を持つモデルは、テキストを抽出と画像の要約を抽出もできます。
テキストブロックを検出には、専用に対応したモデルが必要です。現在対応しているのは次のとおりです。
- ローカルテキストブロック検出器: モデルをダウンロードして、漫画のページ上のテキスト領域を見つけます。オフラインで動作し、無料で使用できます。テキストの抽出には別のモデルが必要です。推奨のオプションです。
- PaddleOCR VL 1.6: API が必要です。検出時にテキストを抽出することもできます。
- GLM-OCR: API が必要です。検出時にテキストを抽出することもできます。
テキストを抽出にも、専用に統合されたオプションがあります。
- ローカルテキスト抽出器: モデルをダウンロードして、デバイス上で直接テキストを抽出します。オフラインで動作し、無料で使用できます。
設定で問題が発生した場合や提案がある場合は、Discord のコミュニティディスカッションにご参加ください。